AIGC & 深度学习
自然语言处理 (NLP)
关于
您好!欢迎来到我的项目集,我是 Elvira。
我是一名对数据智能和Web开发充满热情的学生。本网站用于展示我在学习过程中所完成的项目。 我热衷于探索、学习和构建有价值的项目。
联系方式
邮箱: zhyyscm@foxmail.com
面向计算机专业的智能辅学系统设计与实现
这是我的本科毕业设计项目。针对计算机专业课程知识点繁杂、缺乏定制化辅导等痛点,本项目基于大语言模型(GLM-4)与检索增强生成(RAG)技术,构建了一个垂直领域的智能辅学平台。
系统核心功能包括:带页码溯源的防幻觉智能答疑、动态专项习题构造以及个性化学习路线规划。底层通过 PyMuPDF 和 PaddleOCR 实现了多源教辅资料的多模态结构化解析,并利用 FAISS 构建了本地高维向量知识库。
点击将打开完整的 Flask 服务应用
核心架构图
核心代码亮点 (双路召回 RAG)
# qa_chain.py 核心召回逻辑片段
def ask_question(session_id, query):
    # 1. 意图前置路由 (Agentic Router),精准拦截闲聊指令
    # 2. 本地 FAISS 高维向量检索,捕获核心教材片段
    local_docs = vector_store.similarity_search(query, k=5)

    # 3. 动态时间锚点注入,调用 Bocha API 抓取全网最新快照
    web_docs = get_bocha_web_search(query, count=2)

    # 4. 组装上下文,强制模型执行来源溯源规则
    system_prompt = f"""
    【诚实边界声明】:你的本地知识库目前仅包含《数据结构》等四门课程。
    如果上下文的【检索到的参考资料】中包含了【用户上传】的文本,
    你必须绝对优先依据该用户上传资料的内容进行深入解答!
    """
    # 5. GLM-4 模型推演与 SSE 流式输出...
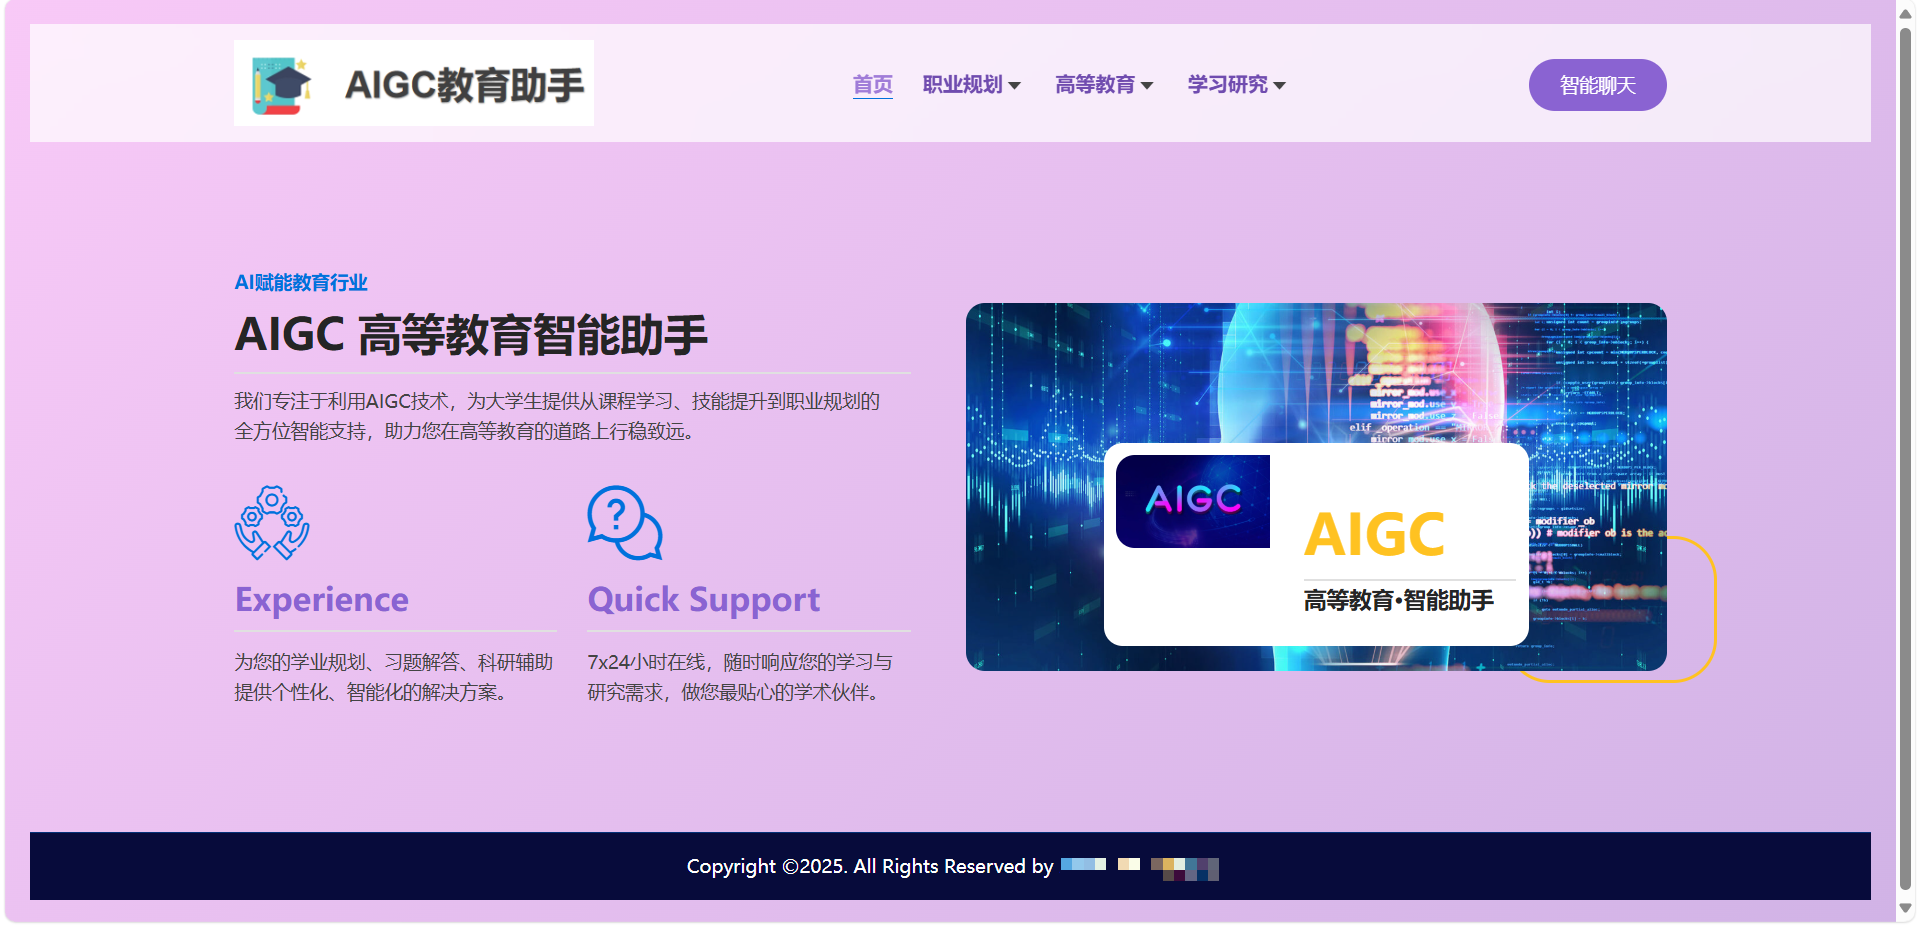
基于langchain的AIGC高等教育助手
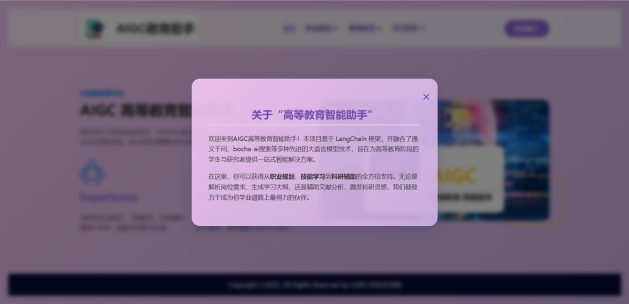
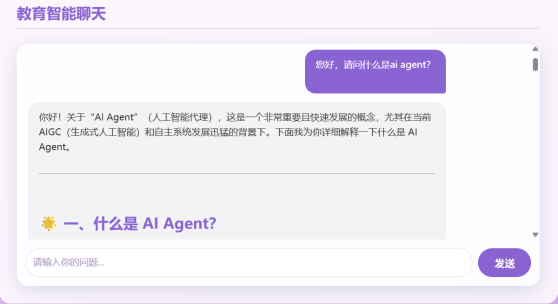
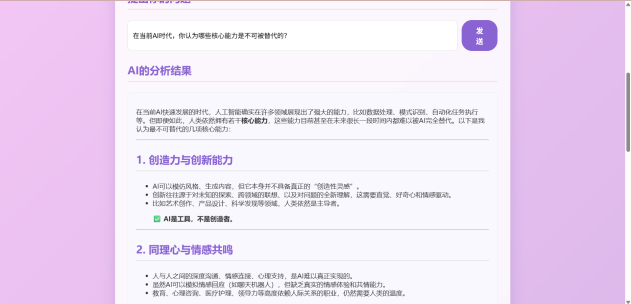
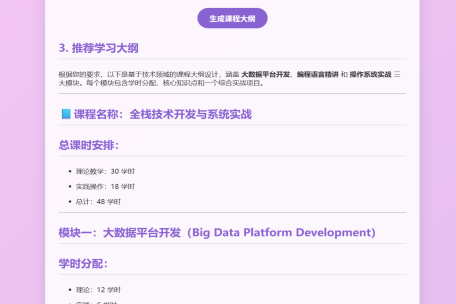
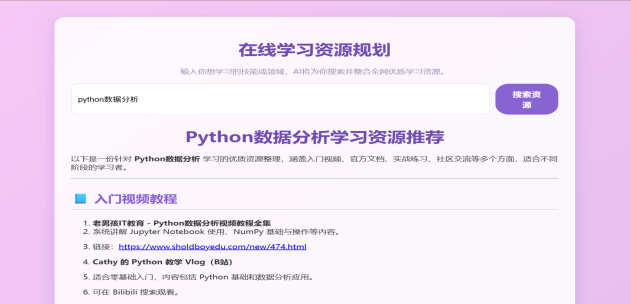
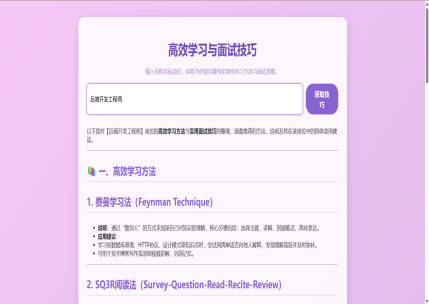
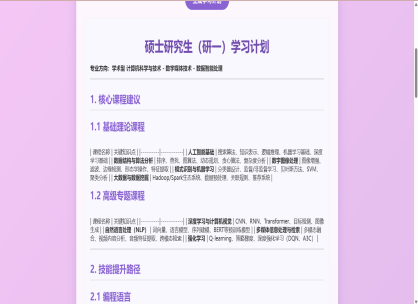
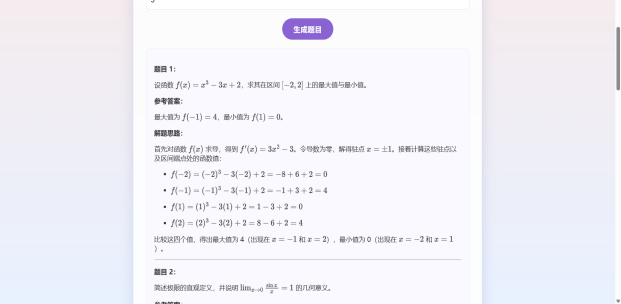
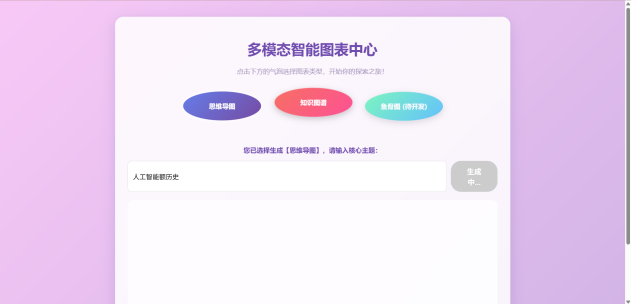
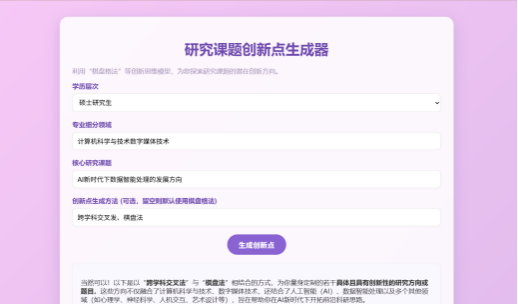
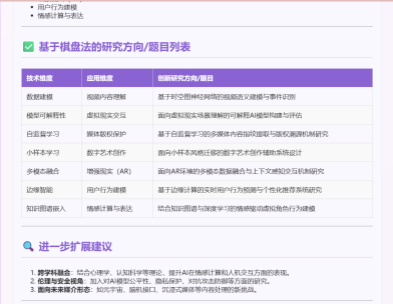
本项目是一个通过AI赋能求职、学习与科研的大模型集成应用,以Python和Flask为后端,LangChain为核心AI引擎,Vue.js为前端。面向正在学校修读专业课程、正在寻找实习或者是正在为科研或大创项目寻找合适选题的大学生。 下方嵌入的是该项目的“静态前端演示”,可体验基本的前端交互。
项目截图
代码示例 (RAG流程)
# LLM.py: 关键的RAG(检索增强生成)链
def build_qa_chain(vector_store):
    prompt = ChatPromptTemplate.from_template("""
    基于以下上下文回答提问:
    {context}
    问题:{input}
    要求:
    1. 使用中文回答
    2. 引用具体页码
    3. 分点陈述关键信息
    """)
    document_chain = create_stuff_documents_chain(llm=qianwen, prompt=prompt)
    return create_retrieval_chain(retriever=vector_store.as_retriever(search_kwargs={"k": 5}),
                                  combine_docs_chain=document_chain)


# AIChatUI.py流式输出
def get_stream_response(messages):
    try:
        client = OpenAI(...) # 省略API Key

        stream = client.chat.completions.create(
            model="qwen-plus",
            messages=messages,
            stream=True # 关键参数:开启流式输出
        )

        for chunk in stream:
            content = chunk.choices[0].delta.content
            if content is not None:
                sse_data = {"text": content}
                yield f"data: {json.dumps(sse_data)}\n\n"

    except Exception as e:
        ... # 此处省略错误处理
基于peddle paddle框架深度学习生物序列预测
为解决生物信息学中“miRNA-gene关系预测”的二分类难题,本项目基于飞桨(Paddle Paddle)框架,从零开始实现了完整的模型定义、训练与评估流程...
模型架构图
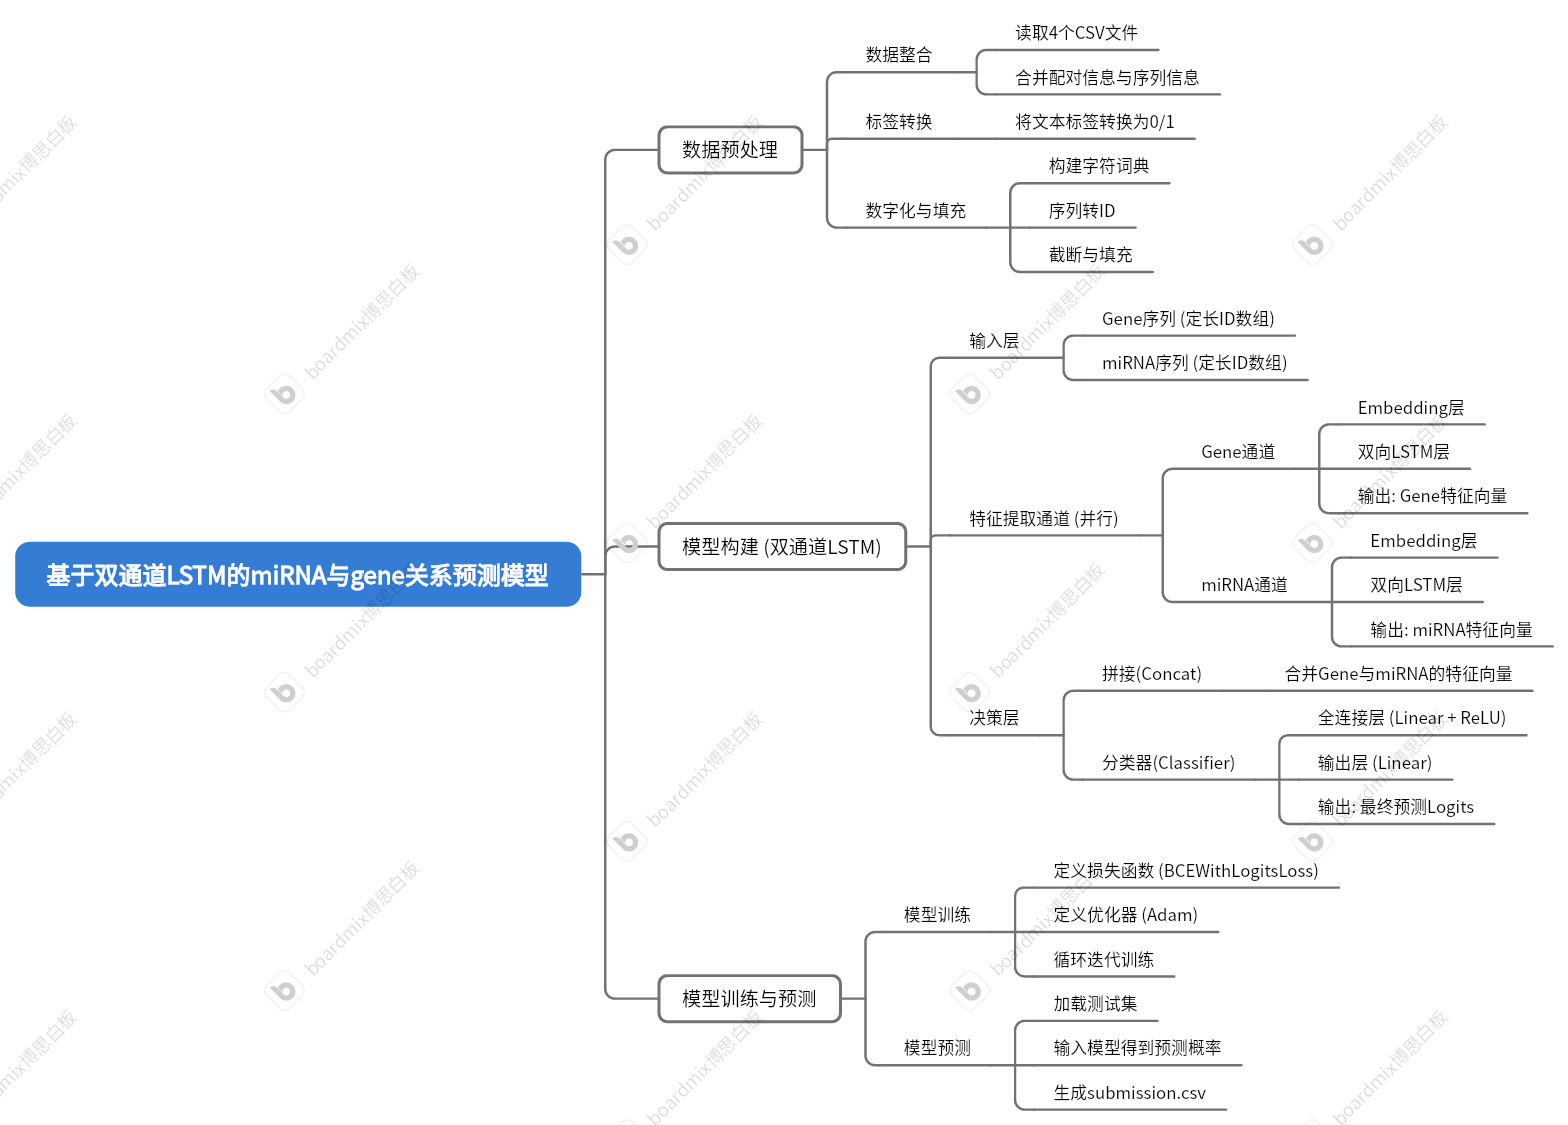
代码示例 (Paddle Paddle 模型定义)
# 示例:Paddle Paddle 模型定义 (伪代码)
import paddle
import paddle.nn as nn

class BiLSTMModel(nn.Layer):
    def __init__(self, vocab_size, emb_size, hidden_size):
        super(BiLSTMModel, self).__init__()
        # ... (模型定义)

    def forward(self, seq1, seq2):
        # ... (前向传播)
        return self.sigmoid(logits)